| Variable | Modalité | n | % observé | % pondéré [IC 95 %] |
|---|---|---|---|---|
| degre | Collège | 727 | 48,2 | 42,1 [42,1 ; 42,1] |
| degre | Premier degré | 782 | 51,8 | 57,9 [57,9 ; 57,9] |
| sexe | Femme | 1 078 | 71,4 | 72,2 [72,2 ; 72,2] |
| sexe | Homme | 431 | 28,6 | 27,8 [27,8 ; 27,8] |
| statut | Contractuel | 94 | 6,2 | 5,8 [4,7 ; 7,0] |
| statut | Maître contractuel ou agréé | 203 | 13,5 | 15,4 [14,8 ; 16,1] |
| statut | Maître délégué | 21 | 1,4 | 1,7 [1,1 ; 2,5] |
| statut | Titulaire | 1 191 | 78,9 | 77,2 [76,0 ; 78,3] |
| secteur | Privé sous contrat | 224 | 14,8 | 17,1 [17,1 ; 17,1] |
| secteur | Public | 1 285 | 85,2 | 82,9 [82,9 ; 82,9] |
| education_prioritaire | Hors EP | 1 155 | 76,5 | 83,4 [83,4 ; 83,4] |
| education_prioritaire | REP | 207 | 13,7 | 11,9 [11,9 ; 11,9] |
| education_prioritaire | REP+ | 147 | 9,7 | 4,7 [4,7 ; 4,7] |
| territoire | Périurbain | 457 | 30,3 | 31,1 [28,8 ; 33,6] |
| territoire | Rural | 299 | 19,8 | 21,5 [19,4 ; 23,7] |
| territoire | Urbain | 753 | 49,9 | 47,4 [44,8 ; 49,9] |
| equipement_numerique | Bon | 510 | 33,8 | 33,6 [31,2 ; 36,1] |
| equipement_numerique | Faible | 274 | 18,2 | 18,5 [16,6 ; 20,6] |
| equipement_numerique | Moyen | 725 | 48,0 | 47,9 [45,3 ; 50,5] |
| participation_formation | Aucune | 526 | 34,9 | 35,1 [32,7 ; 37,7] |
| participation_formation | Au moins un jour | 983 | 65,1 | 64,9 [62,3 ; 67,3] |
Observatoire statistique des pratiques enseignantes
Démonstrateur méthodologique d’une étude statistique sur les pratiques professionnelles des enseignants
Données simulées à des fins de démonstration méthodologique. Les résultats présentés ne constituent pas des résultats officiels de la DEPP.
1 Résumé
Ce démonstrateur reproduit une étude des pratiques déclarées à partir d’une population de 100 000 enseignants fictifs. Un échantillon stratifié de 2 000 unités donne 1 521 répondants simulés, soit 76,0 %. La base analytique comprend 1 509 observations après contrôle qualité.
Les analyses décrivent huit dimensions de pratiques, examinent leurs propriétés psychométriques et construisent une partition exploratoire en 2 profils. Sa silhouette moyenne de 0,142 invite à ne pas interpréter les groupes comme des catégories naturelles. Les modèles pondérés documentent des associations conditionnelles, sans inférence causale. Tous les résultats numériques ci-dessous proviennent des fichiers calculés par le pipeline.
2 Contexte
L’étude des pratiques enseignantes exige de distinguer les déclarations individuelles, leurs conditions d’exercice et les instruments utilisés pour les mesurer. Le projet reproduit cette articulation dans un cadre entièrement synthétique. Il ne décrit ni une enquête conduite par la DEPP ni la distribution réelle des pratiques dans le système éducatif.
3 Problématique
Quels profils de pratiques professionnelles peut-on identifier à partir des déclarations d’enseignement explicite, de différenciation, d’évaluation formative, de gestion de classe, de collaboration, d’usage pédagogique du numérique, de développement professionnel et de relations éducatives ? Une seconde question concerne les écarts entre fréquence déclarée, faisabilité et priorité.
4 Objectifs
L’étude vise à construire un dispositif d’enquête cohérent, expliciter le traitement de la qualité et du sondage, produire des indicateurs pondérés et examiner la structure des mesures. Elle explore ensuite les profils multivariés et leurs associations avec le contexte. La restitution doit rester traçable et reproductible, y compris lorsque les résultats sont peu discriminants ou incertains.
5 Méthodologie
La démarche sépare la génération des données, leur audit, les règles d’inclusion et l’analyse. Les informations réservées au simulateur ne servent pas à décider de la qualité des réponses. Les données brutes sont préservées ; les transformations et exclusions sont consignées.
Les descriptions et régressions utilisent le plan d’enquête calibré. La psychométrie, l’analyse factorielle et la classification sont exploratoires et non pondérées : leurs résultats concernent la structure de l’instrument dans les cas analysés, et non une estimation représentative de la population enseignante réelle. Les dénominateurs sont propres à chaque indicateur ; aucune imputation générale n’est réalisée.
6 Questionnaire
L’instrument comporte six items pour chacune des huit dimensions : EXP, DIF, EVA, GCL, COL, NUM, DEV et REL. Les 48 réponses de pratique vont de 1 (« Jamais ») à 5 (« Très souvent »). Huit questions de faisabilité et huit de priorité complètent ces blocs, avec leurs propres ancrages ordinaux. Quatre contrôles sont exclus des échelles principales ; CTRL02 et CTRL04 sont orientés à l’inverse et leur recodage exploratoire est explicite.
Comparer directement priorité et fréquence suppose une convention de métrique : le GAP décrit une différence de codes, pas un besoin objectivement mesuré. Le questionnaire complet figure en annexe.
7 Population et plan de sondage
La population synthétique couvre premier degré et collège, public et privé sous contrat, éducation prioritaire et territoires urbains, périurbains ou ruraux. Les enseignants du privé sont classés Hors EP par convention de simulation. Le premier degré est polyvalent ; le collège comprend plusieurs disciplines.
Le tirage est aléatoire simple sans remise dans chacune des huit strates opérationnelles croisant degré, secteur et éducation prioritaire. L’allocation est fixée avant tirage ; elle n’est pas proportionnelle partout. Pour une strate \(h\) de taille \(N_h\) et une allocation \(n_h\) :
\[\pi_h=\frac{n_h}{N_h},\qquad w_h=\frac{1}{\pi_h}=\frac{N_h}{n_h}.\]
L’unité statistique et de tirage est l’enseignant fictif. Aucun regroupement réel par établissement n’est reproduit. Le détail de l’allocation est fourni dans les annexes.
8 Simulation des données
Les caractéristiques individuelles sont générées sous contraintes de cohérence entre âge, ancienneté, secteur et contexte. Les paramètres sont des choix de démonstration, pas des estimations officielles.
Les huit traits continus sont issus d’une loi normale multivariée dont la matrice théorique est positive définie et modérément corrélée. Des associations contextuelles modérées et du bruit sont ajoutés. Une réponse latente combine le trait, une saturation propre à l’item et une erreur ; des seuils variables la transforment en cinq modalités. Les items ne sont donc pas tirés indépendamment.
La participation est simulée par un mécanisme logistique dépendant de caractéristiques observées. Les manquants partiels, la concentration des omissions en fin de questionnaire, les durées courtes et les réponses uniformes sont introduits séparément. Les dépendances statistiques intégrées aux données sont des hypothèses de simulation et ne constituent pas des résultats empiriques sur les enseignants.
9 Contrôle qualité
Le référentiel distingue structure, identifiants, domaines, cohérences, complétion, temps de réponse et straightlining. Les durées courtes et réponses uniformes constituent des alertes, pas des preuves isolées d’invalidité. La base brute contient 25 réponses rapides et 30 alertes de straightlining ; ces catégories peuvent se chevaucher.
La règle principale exige au moins la moitié des questions et au moins 24 items de pratiques valides. Elle traite les doublons selon une priorité reproductible et exclut certains cumuls d’alertes graves. Les cas suffisamment renseignés ne sont pas exclus sur leur seul statut d’abandon. Au total, 12 questionnaires répondants ne sont pas retenus. Les critères détaillés et diagnostics sont disponibles en annexe.
10 Pondération
La correction de non-réponse porte sur les observations analytiques incluses, donc sur la non-participation et les exclusions qualité. Dans chaque cellule, le poids de base est multiplié par le rapport sélectionnés/inclus. Cette correction suppose une comparabilité suffisante des inclus et non-inclus au sein de la cellule, sans garantir l’absence de biais résiduel.
La calibration utilise une distance logit avec multiplicateurs bornés entre 0,5 et 2. Elle conserve les totaux des huit strates, donc les marges degré, secteur et EP, et ajoute le sexe et le total de la durée anciennete_classe. Cette dernière est une variable numérique, non une tranche d’ancienneté. Aucun score de pratique n’entre dans les contraintes. Le plan final conserve les informations de calibration pour les variances. Les détails des marges et diagnostics figurent en annexe. Les incertitudes restent conditionnelles au plan de travail : toute l’incertitude de simulation, de non-réponse ou de construction des scores n’est pas propagée.
11 Analyses descriptives
Le tableau 1 conserve les effectifs observés et distingue les distributions pondérées et non pondérées. Les IC quasi nuls d’une marge calibrée traduisent une contrainte du redressement, pas une précision empirique exceptionnelle. Les tableaux détaillés incluent les variables continues et les dénominateurs disponibles.
Source : base analytique simulée ; poids finaux calibrés. Les proportions utilisent les réponses disponibles par variable.
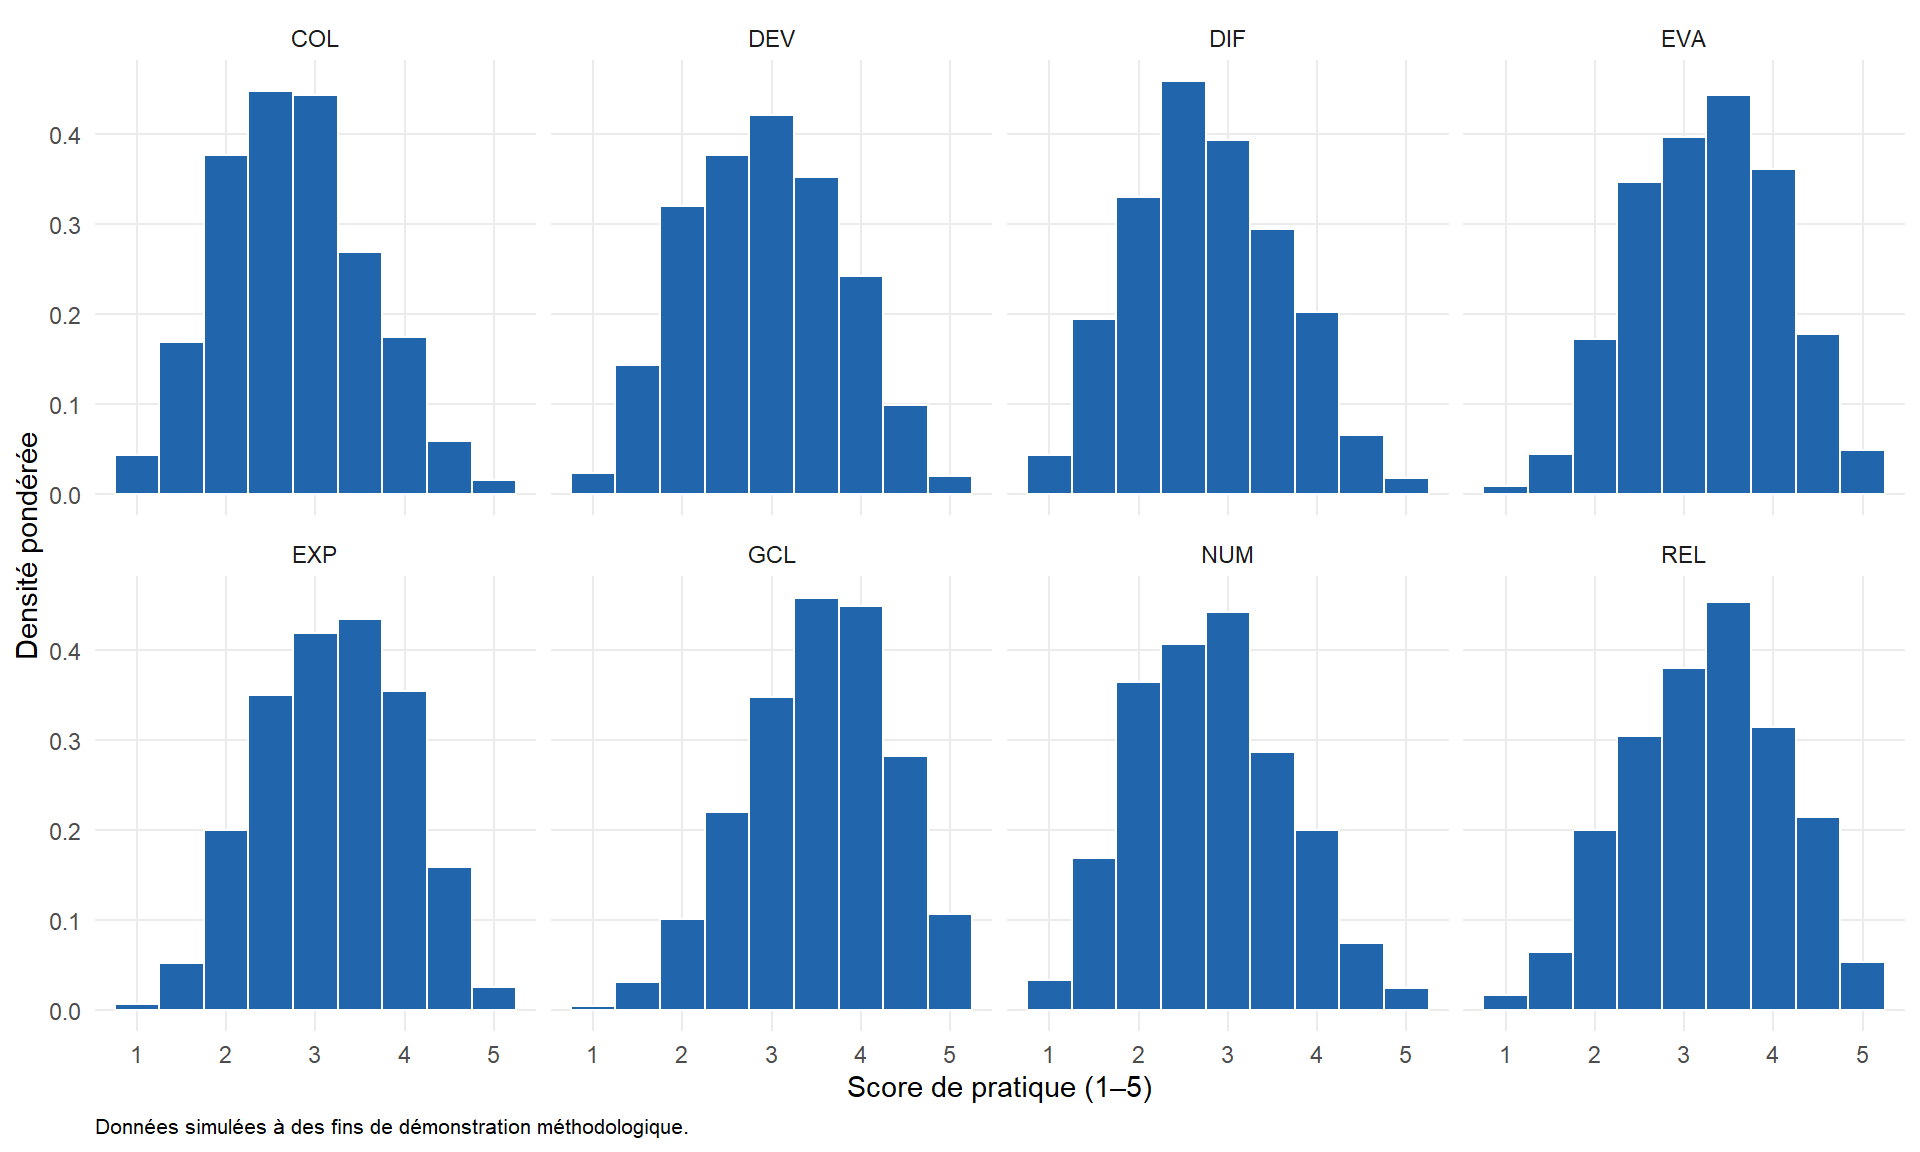
Source : base analytique simulée. Chaque panneau utilise les scores disponibles ; l’aire est normalisée à un. La validation interne qui autorise ces scores est décrite dans les sections suivantes.
12 Validation psychométrique
L’examen combine distributions, effets plafond/plancher, relations item-total, corrélations polychorïques, alpha, oméga, adéquation factorielle et contenu des items. Aucun item n’est supprimé sur le seul critère de l’alpha. Les analyses par bloc utilisent les cas complets sur les six items ; les effectifs sont explicités dans le tableau 2.
| Dimension | Cas complets | Alpha brut | Oméga ordinal |
|---|---|---|---|
| EXP | 1 429 | 0,743 | 0,774 |
| DIF | 1 441 | 0,803 | 0,829 |
| EVA | 1 445 | 0,775 | 0,802 |
| GCL | 1 431 | 0,796 | 0,826 |
| COL | 1 426 | 0,789 | 0,818 |
| NUM | 1 425 | 0,811 | 0,836 |
| DEV | 1 430 | 0,796 | 0,823 |
| REL | 1 419 | 0,825 | 0,849 |
Source : items simulés, analyse non pondérée. L’alpha sur les codes observés et l’oméga du modèle latent ordinal ne mesurent pas exactement la même quantité. L’oméga suppose un modèle congénérique à erreurs non corrélées ; une valeur élevée ne prouve ni unidimensionnalité ni validité externe.
Les alphas observés vont de 0,743 à 0,825. Leur niveau est compatible avec la structure introduite par la simulation ; il ne valide pas l’usage de l’instrument auprès d’enseignants réels.
13 Analyse factorielle
L’analyse parallèle globale porte sur 1 161 cas complets et 48 items. Elle suggère 8 facteurs, à comparer aux 8 dimensions théoriques. L’extraction minres et la rotation oblimin autorisent des facteurs corrélés. La lecture du contenu accompagne les charges et les éventuelles charges croisées ; une concordance numérique avec le modèle générateur ne constitue pas une validation externe.
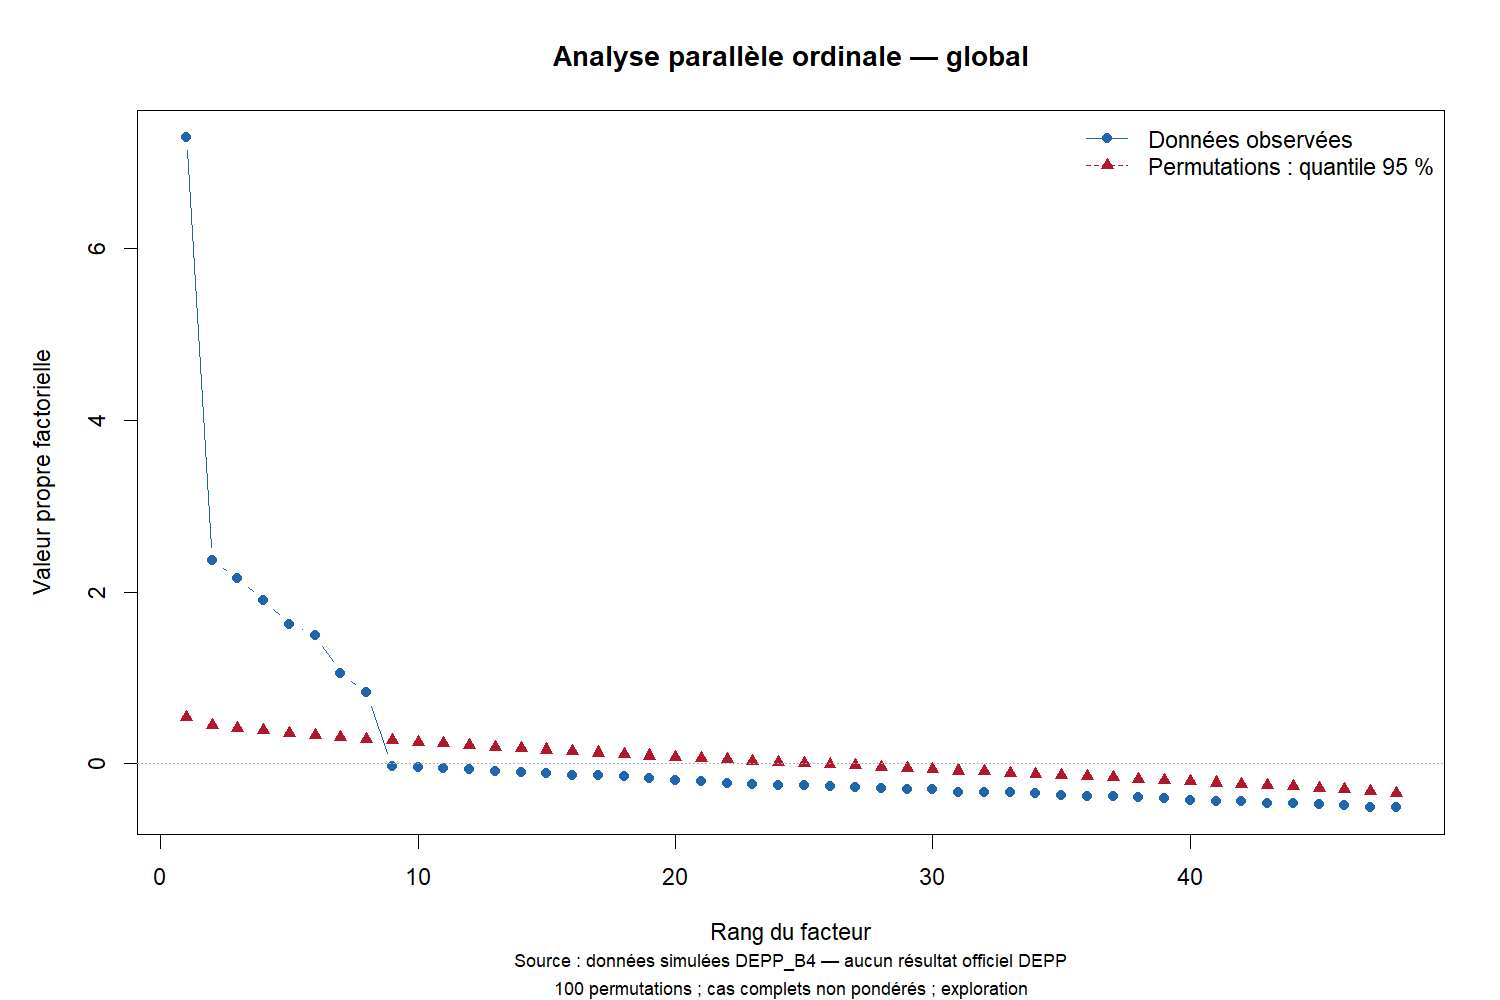
Source : items simulés, corrélations polychorïques, cas complets non pondérés. La référence repose sur des permutations des items ; le nombre de facteurs dépend aussi de l’incertitude Monte-Carlo et de la lecture conceptuelle.
Les scores retenus sont les moyennes des items autorisés, sous condition de complétion. Les règles propres à chaque dimension sont annexées. Leur standardisation conserve les scores 1–5 et ajoute des Z pour les analyses multivariées.
| Dimension | n | Moyenne [IC 95 %] | Écart-type pondéré |
|---|---|---|---|
| EXP | 1 503 | 3,20 [3,16 ; 3,24] | 0,791 |
| DIF | 1 500 | 2,77 [2,73 ; 2,81] | 0,842 |
| EVA | 1 503 | 3,25 [3,21 ; 3,30] | 0,801 |
| GCL | 1 500 | 3,52 [3,48 ; 3,56] | 0,799 |
| COL | 1 504 | 2,74 [2,70 ; 2,78] | 0,807 |
| NUM | 1 498 | 2,81 [2,77 ; 2,85] | 0,843 |
| DEV | 1 496 | 2,92 [2,87 ; 2,96] | 0,839 |
| REL | 1 488 | 3,25 [3,20 ; 3,29] | 0,849 |
Source : base analytique simulée ; réponses disponibles par score et plan calibré. Les comparaisons de niveau entre dimensions restent sensibles aux contenus et aux seuils des items.
14 Typologie
L’ACP explore les scores standardisés sans remplacer l’analyse factorielle des items. La CAH utilise la distance euclidienne et Ward.D2 sur les huit Z complets. Les solutions de deux à six classes sont comparées par silhouette, inertie, tailles, stabilité et interprétation. La partition retenue porte sur 1 463 enseignants ; 46 restent non classés sans être supprimés de la base.
| Profil | Description | n | Part pondérée |
|---|---|---|---|
| PROFIL_1 | Pratiques déclarées moins fréquentes, notamment numériques | 915 | 61,8 % |
| PROFIL_2 | Pratiques déclarées plus fréquentes, contraste numérique marqué | 548 | 38,2 % |
Source : classification non pondérée ; parts pondérées parmi les seuls classés. Les noms comparent les fréquences déclarées entre groupes, sans jugement de qualité professionnelle.
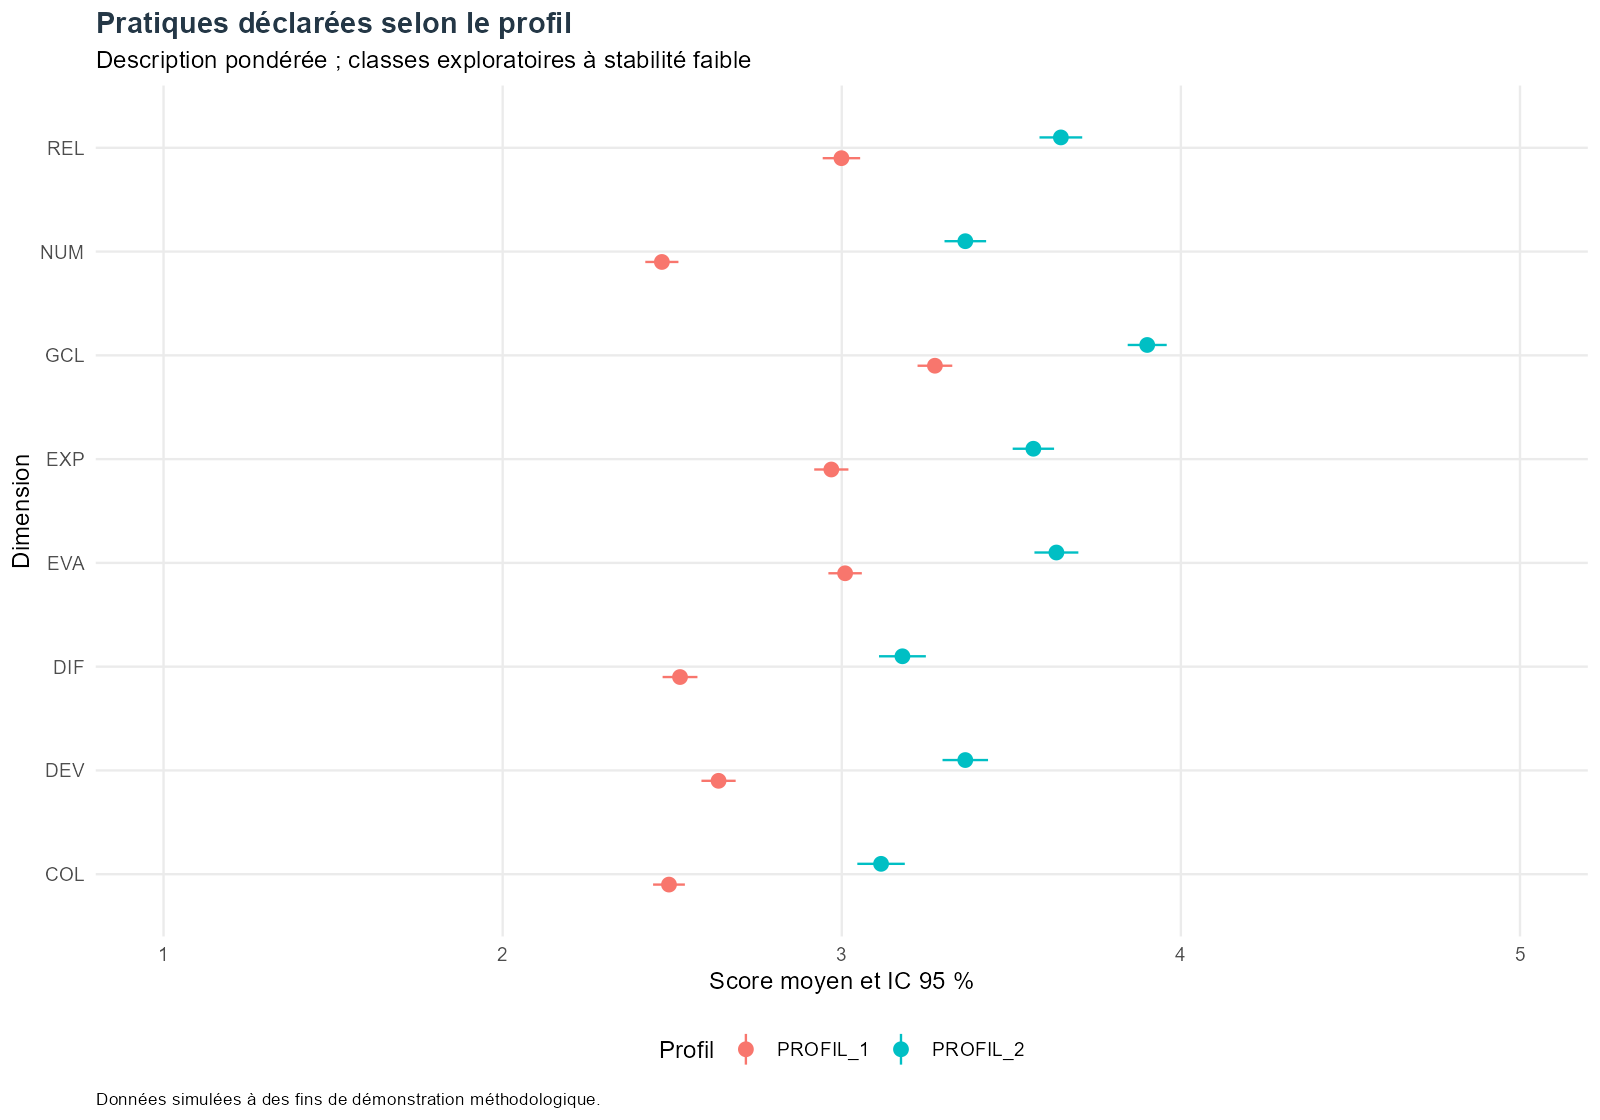
Source : base analytique simulée, poids finaux. Les IC sont conditionnels à la partition et ne représentent pas l’incertitude de classification.
L’ARI moyen de stabilité par sous-échantillonnage vaut 0,290. La concordance CAH/k-means est de 0,466. La stabilité est faible : les profils représentent principalement un gradient de déclaration, pas des types pédagogiques fermement établis.
15 Modélisation
Les modèles gaussiens pondérés étudient DIF, EVA, NUM et GAP_DIF ; la logistique compare le profil 2 au profil 1. Ils utilisent des cas complets propres à chaque réponse. Les spécifications progressives d’une même réponse sont ajustées sur les mêmes individus. L’âge et l’ancienneté ne sont pas inclus simultanément ; les autres covariables sont choisies selon leur pertinence et leur redondance, pas seulement selon leur p-value.
Les variantes quadratiques et l’interaction équipement × degré sont conservées comme examens ciblés. Le modèle principal reste parcimonieux. Les sensibilités comparent pondération et règles qualité, sans recalibrer les poids après restriction stricte. Les diagnostics de résidus, influence et colinéarité n’entraînent aucune exclusion automatique.
| Réponse | Association | Coefficient ou OR [IC 95 %] | n |
|---|---|---|---|
| SCORE_DIF | formation_continue | 0,006 [-0,011 ; 0,024] | 1 484 |
| SCORE_DIF | SCORE_DEV | 0,345 [0,291 ; 0,399] | 1 484 |
| SCORE_EVA | formation_continue | 0,045 [0,030 ; 0,061] | 1 476 |
| SCORE_EVA | SCORE_EXP | 0,287 [0,238 ; 0,335] | 1 476 |
| SCORE_NUM | equipement_numeriqueBon | 0,666 [0,542 ; 0,790] | 1 498 |
| GAP_DIF | CONTRAINTE_DIF | 0,043 [-0,017 ; 0,103] | 1 372 |
| profil_2 | formation_continue | 1,060 [1,014 ; 1,109] | 1 463 |
| profil_2 | equipement_numeriqueBon | 1,787 [1,285 ; 2,487] | 1 463 |
Source : modèles survey sur données simulées. Les coefficients gaussiens sont en points ; la logistique présente des odds ratios du profil 2 versus 1. Formation : un jour supplémentaire. Équipement Bon : référence Faible. Les autres scores sont sur 1–5. Les coefficients complets et références figurent en annexe. Les OR ne sont pas des rapports de probabilités.
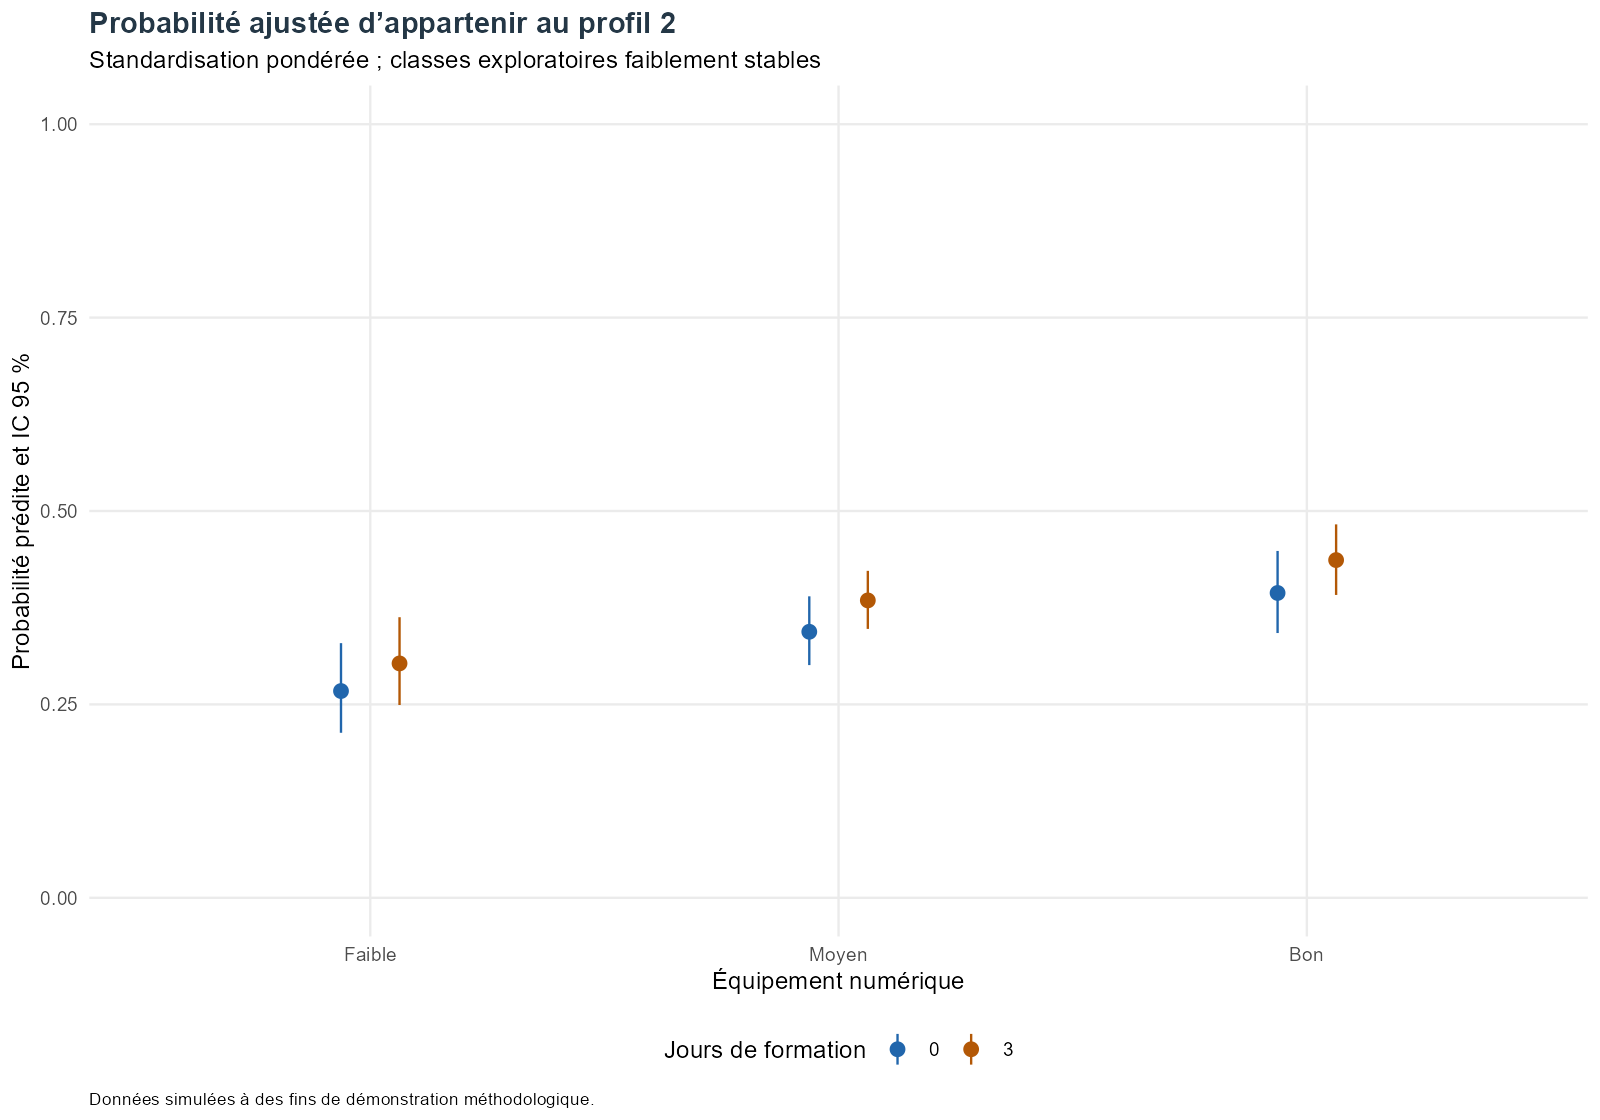
Source : logistique pondérée simulée. Standardisation sur les covariables observées ; IC delta conditionnels aux classes et à la distribution empirique des covariables. Ces configurations sont descriptives et ne représentent pas des interventions causales.
16 Résultats principaux
Le tableau 3 donne les estimations et IC de chaque score. Les écarts entre dimensions dépendent en partie des difficultés d’items fixées par le simulateur ; un classement des moyennes ne démontre donc pas une hiérarchie réelle des pratiques.
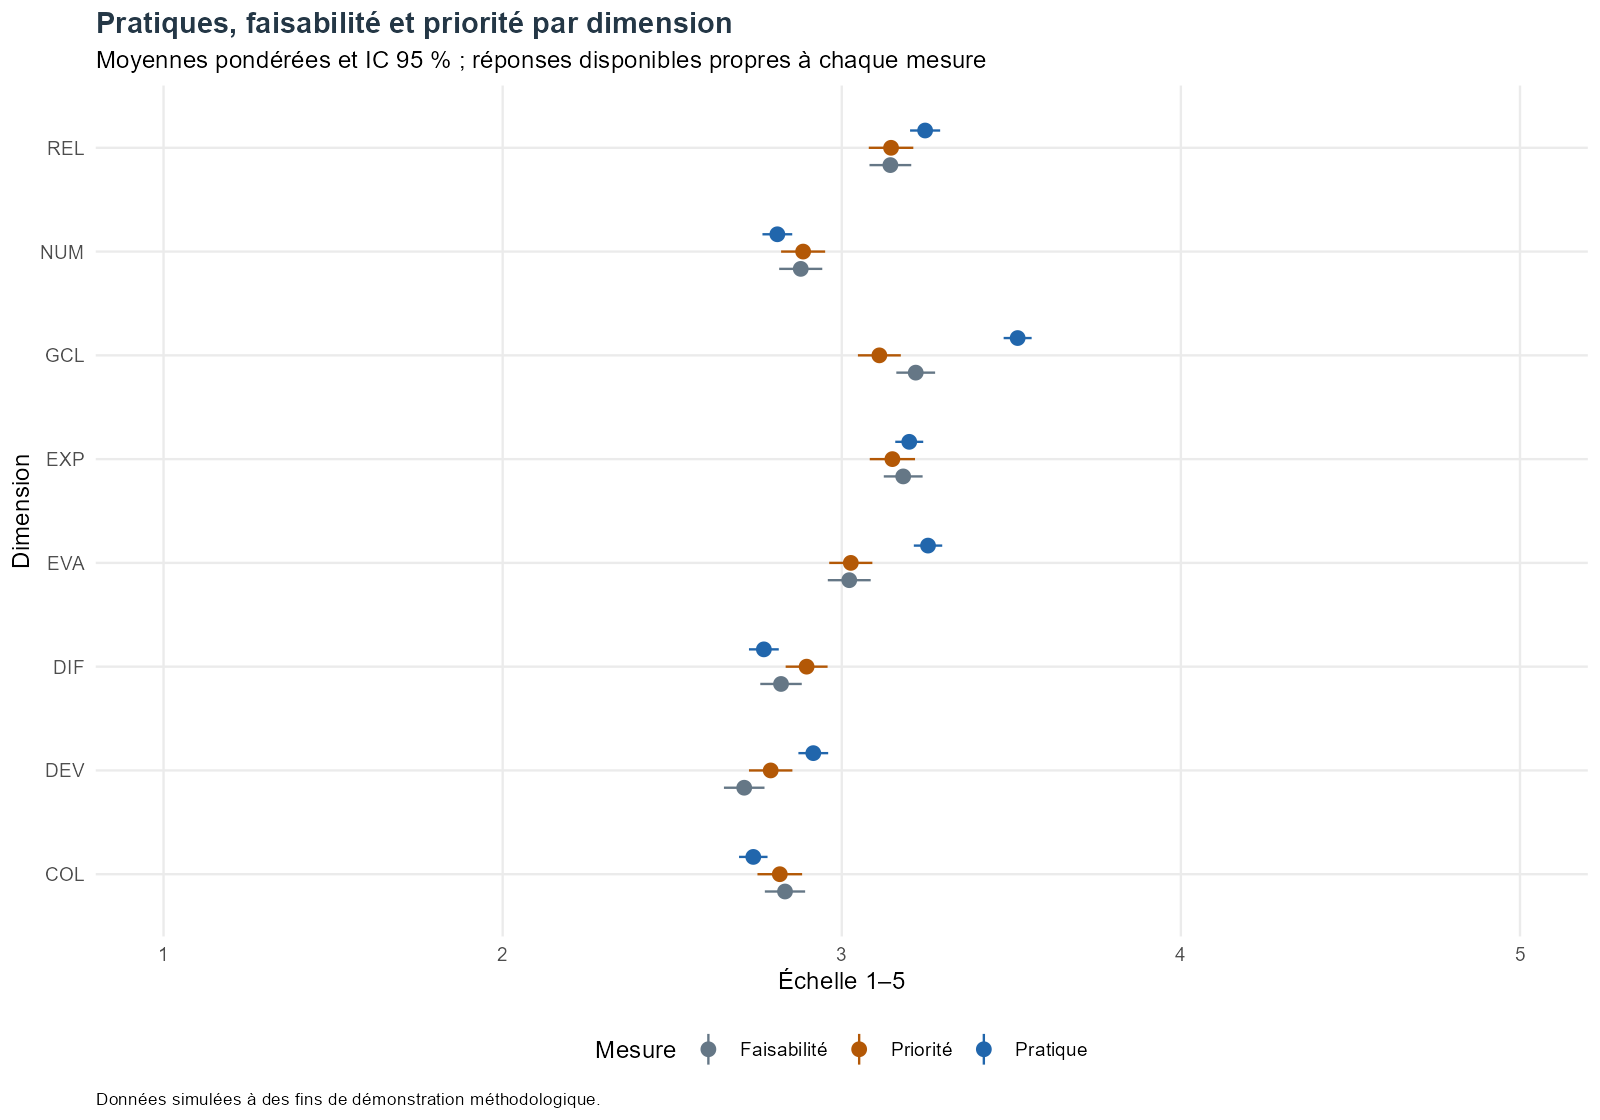
Source : base analytique simulée. Les trois mesures ont des ancrages différents et des dénominateurs disponibles propres ; le GAP est calculé séparément sur les paires renseignées.
L’association ajustée entre bon équipement et NUM est de 0,666 [0,542 ; 0,790] point(s), IC 95 %, par rapport à un équipement faible. Pour EVA, l’association à un jour supplémentaire de formation est de 0,045 [0,030 ; 0,061] point(s). Leur amplitude doit être appréciée sur l’échelle 1–5, indépendamment de la seule exclusion de zéro par l’IC.
Dans le premier profil, l’écart moyen priorité–pratique le plus élevé concerne NUM : 0,302 [0,216 ; 0,388] point(s), IC 95 %, sur 871 paires disponibles. Ce constat décrit un écart déclaré, sans prouver un besoin de mise en œuvre.
Pour GAP_DIF, le coefficient de contrainte déclarée vaut 0,043 [-0,017 ; 0,103]. L’IC inclut zéro : l’hypothèse d’un écart croissant avec la contrainte n’est pas étayée de manière concluante. Le R² descriptif du modèle vaut 0,021 : ce diagnostic décrit l’ajustement, sans valider un mécanisme explicatif.
17 Discussion
Le démonstrateur montre qu’un pipeline peut produire des résultats techniquement cohérents sans qu’ils deviennent pour autant des connaissances sur la population réelle. La fidélité et la structure factorielle reflètent notamment les dépendances utilisées pour générer les réponses. Leur examen reste nécessaire pour détecter des défauts du dispositif, mais insuffisant pour établir une validité externe.
Les profils rendent lisible un gradient multivarié ; leur faible stabilité limite une utilisation individuelle ou décisionnelle. Les écarts priorité–pratique sont des écarts déclarés, et non des besoins réels prouvés. Les associations avec formation ou équipement illustrent l’ajustement statistique, sans isoler un mécanisme causal. L’intérêt méthodologique réside dans la confrontation des spécifications, des dénominateurs et de l’incertitude, y compris lorsque l’association attendue reste peu étayée.
18 Limites
- Les données individuelles sont entièrement simulées ; les comportements répondent à des hypothèses techniques.
- L’étude n’autorise aucune inférence causale. Les covariables et pratiques sont contemporaines.
- Les pratiques sont déclaratives : une collecte réelle serait exposée aux biais de mémoire et de désirabilité sociale.
- Le plan de sondage est simplifié, notamment sans dépendance réelle entre enseignants d’un même établissement.
- La non-réponse et ses corrections sont simplifiées ; la calibration ne garantit pas l’élimination du biais.
- Les échelles n’ont pas fait l’objet d’une validation externe ou d’un prétest auprès d’enseignants réels.
- La psychométrie non pondérée et les cas complets peuvent sélectionner une sous-population particulière.
- Le clustering dépend des scores, de la distance, de la méthode et du nombre de classes ; sa faible stabilité est observée et non masquée.
- Les IC ne propagent pas toute l’incertitude des étapes successives. Les comparaisons multiples restent exploratoires.
19 Conclusion
La chaîne mise en œuvre permet de construire un dispositif d’enquête, gérer les probabilités d’inclusion, tracer la qualité, corriger les poids et produire des indicateurs. Elle examine la cohérence interne des échelles, explore la structure factorielle et les profils, puis ajuste des modèles associatifs. La restitution automatisée relie chaque estimation aux résultats calculés. Cette capacité méthodologique ne transforme pas la simulation en résultat empirique : la validation externe et une collecte réelle resteraient indispensables.
20 Annexes méthodologiques
Les annexes présentent le questionnaire, les dictionnaires, l’allocation, les contrôles qualité, les résultats psychométriques détaillés, les charges factorielles, les sensibilités et les diagnostics des modèles.